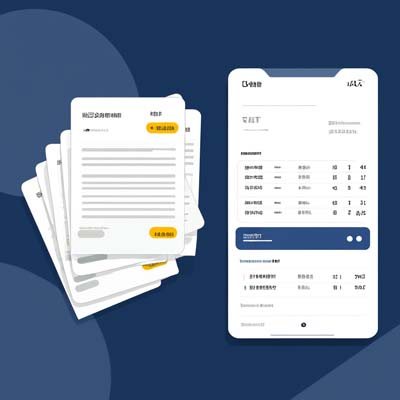
बिल OCR
रेस्टोरेंट बिल → खर्च रिपोर्ट
दुकान का नाम, तारीख, राशि और टैक्स फील्ड बैच में पहचानें, हिसाब और रीइम्बर्समेंट के लिए लाइन आइटम निकालें।
स्क्रीनशॉट, फोटो, PDF और स्कैन किए गए दस्तावेज़ों से टेक्स्ट एक क्लिक में निकालें। बिना रजिस्ट्रेशन, बिना लिमिट, हमेशा मुफ्त। 30+ फॉर्मेट और 100+ भाषाओं के लिए।
फाइलें यहां खींचें और छोड़ें, या नीचे दिया बटन दबाएं · JPG, PNG, BMP, TIFF, GIF, PDF समेत 30+ फॉर्मेट · एक फाइल अधिकतम 10 MB
एक बार में अधिकतम 10 फाइलें · कतार में अधिकतम 10 काम · बैच प्रोसेसिंग उपलब्ध
इमेज अपलोड करें और फोटो से टेक्स्ट निकालना शुरू करें
यह एक तेज़, सटीक और बिल्कुल मुफ्त ऑनलाइन OCR टूल है जो इमेज, PDF और स्कैन किए गए दस्तावेज़ों को एडिट करने योग्य टेक्स्ट में बदलता है। कागज़ के दस्तावेज़ों की फोटो, रसीदें, क्लास नोट्स या कई पन्नों की PDF — कुछ सेकंड में टेक्स्ट निकालें, बिना रजिस्ट्रेशन और बिना किसी सीमा के।
AI-आधारित OCR और बहुभाषी मॉडल की मदद से यह गति के साथ उच्च सटीकता देता है। बुनियादी लेआउट सुरक्षित रखने, पंक्ति/पैराग्राफ के हिसाब से आउटपुट और बैच टास्क की सुविधा है — छात्रों के नोट्स से लेकर ऑफिस के दस्तावेज़ों तक।
सुझाव: बेहतर परिणाम के लिए दस्तावेज़ की फोटो अच्छी रोशनी में, साफ़ और सीधी लें।
फाइल फॉर्मेट: JPG, JPEG, PNG, BMP, GIF, TIFF, WEBP, PDF, AI, EPS, PSD, XPS, DjVu और आम RAW फॉर्मेट (CR2, NEF, ARW, DNG, RAF आदि)। एक फाइल अधिकतम 10 MB। बैच अपलोड और टास्क कतार उपलब्ध।
भाषा समर्थन: 100+ भाषाएं — हिंदी, अंग्रेज़ी, तमिल, बांग्ला, उर्दू, चीनी, जापानी, कोरियाई, फ्रेंच, जर्मन, स्पेनिश, रूसी, अरबी आदि। मिश्रित भाषाओं, अंकों, चिह्नों और सामान्य फ़ॉर्मूलों को भी संभालती है।
दुकान का नाम, तारीख, राशि और टैक्स फील्ड बैच में पहचानें, हिसाब और रीइम्बर्समेंट के लिए लाइन आइटम निकालें।
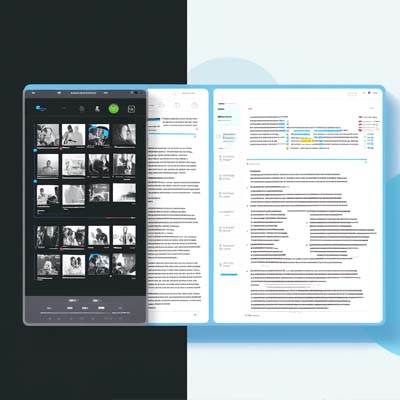
फोटो से टेक्स्ट निकालकर पैराग्राफ में बांटें, टिप्पणियां जोड़ें और अपने नोट्स सिस्टम से जोड़ें।
हेडिंग, पैराग्राफ और पेज नंबर पहचानकर तैयार टेक्स्ट पाएं, फिर चाहें तो सीधे एडिट करें।
आपकी फाइलें हमारे सर्वर पर सुरक्षित रूप से प्रोसेस होती हैं और काम पूरा होने के बाद हटा दी जाती हैं। सेवा बेहतर बनाने के लिए हम केवल बुनियादी मेटाडेटा दर्ज कर सकते हैं।
हम आपकी फाइलें या निकाला गया कंटेंट किसी तीसरे पक्ष के साथ साझा नहीं करते। आपका डेटा सावधानी से संभाला जाता है।
तेज़ OCR इंजन कुछ ही सेकंड में इमेज से टेक्स्ट निकालता है, इंतज़ार की ज़रूरत नहीं।
AI-आधारित इंजन प्रिंटेड टेक्स्ट पर 98%+ सटीकता देता है; स्क्रीनशॉट और स्कैन पर भी बेहतर परिणाम।
फाइलें सर्वर पर सुरक्षित रूप से प्रोसेस होती हैं और काम पूरा होने पर हट जाती हैं।
दैनिक प्रोसेसिंग
OCR सटीकता
समर्थित भाषाएं
हमेशा के लिए
हां, बिल्कुल मुफ्त और हमेशा के लिए। न रजिस्ट्रेशन, न ट्रायल, न छुपी कीमत। इमेज, PDF और स्कैन किए गए दस्तावेज़ों से टेक्स्ट निकालना पूरी तरह मुफ्त है।
30+ फॉर्मेट — JPG, PNG, BMP, TIFF, GIF, PDF, AI, EPS, PSD, XPS, DjVu और RAW फॉर्मेट (CR2, NEF, ARW, DNG, RAF आदि)। एक फाइल अधिकतम 10 MB।
साफ़ प्रिंटेड टेक्स्ट पर 98%+ सटीकता, हस्तलिखित सामग्री पर अच्छे परिणाम। फोटो जितनी साफ़ और सीधी होगी, नतीजा उतना ही बेहतर।
आमतौर पर 1-3 सेकंड प्रति इमेज। कई फाइलें अपने आप कतार में प्रोसेस होती हैं और हर टास्क की स्थिति स्क्रीन पर दिखती है।
हां। फाइलें एन्क्रिप्टेड कनेक्शन से अपलोड होती हैं, प्रोसेस के बाद तुरंत हट जाती हैं और किसी तीसरे पक्ष के साथ साझा नहीं की जातीं। संवेदनशील जानकारी हो तो नाम, खाता नंबर, हस्ताक्षर को पहले ढक लें।
100+ भाषाएं — हिंदी, अंग्रेज़ी, बांग्ला, तमिल, उर्दू, चीनी, जापानी, कोरियाई, फ्रेंच, जर्मन, स्पेनिश, रूसी, अरबी आदि। हिंदी-अंग्रेज़ी मिश्रित टेक्स्ट भी संभाला जाता है।
साफ़ और हाई-रिज़ॉल्यूशन वाली फोटो लें, अतिरिक्त खाली हिस्सा काटें, फोटो सीधी रखें और चमक-छाया से बचें। ज़रूरत हो तो संवेदनशील जगह को पहले ढककर फिर अपलोड करें।